核心信息
Meta Superintelligence Labs 发布了 Muse Voice Transcribe,这是一款实时音频感知模型,支持流式语音转文字、20+ 说话人分离和端点检测,并具备多语种混说切换与偏好设置能力。
要点
- 实时流式语音识别,支持 20+ 说话人分离和自动端点检测。
- 多语种支持,可无缝切换语种;通过语言、关键词和上下文偏好提升准确率。
- 在 Artificial Analysis 流式语音转文字及公开说话人分离基准上排名第一。
Meta Superintelligence Labs 发布了 Muse Voice Transcribe,这是一款实时音频感知模型,支持流式语音转文字、20+ 说话人分离和端点检测,并具备多语种混说切换与偏好设置能力。
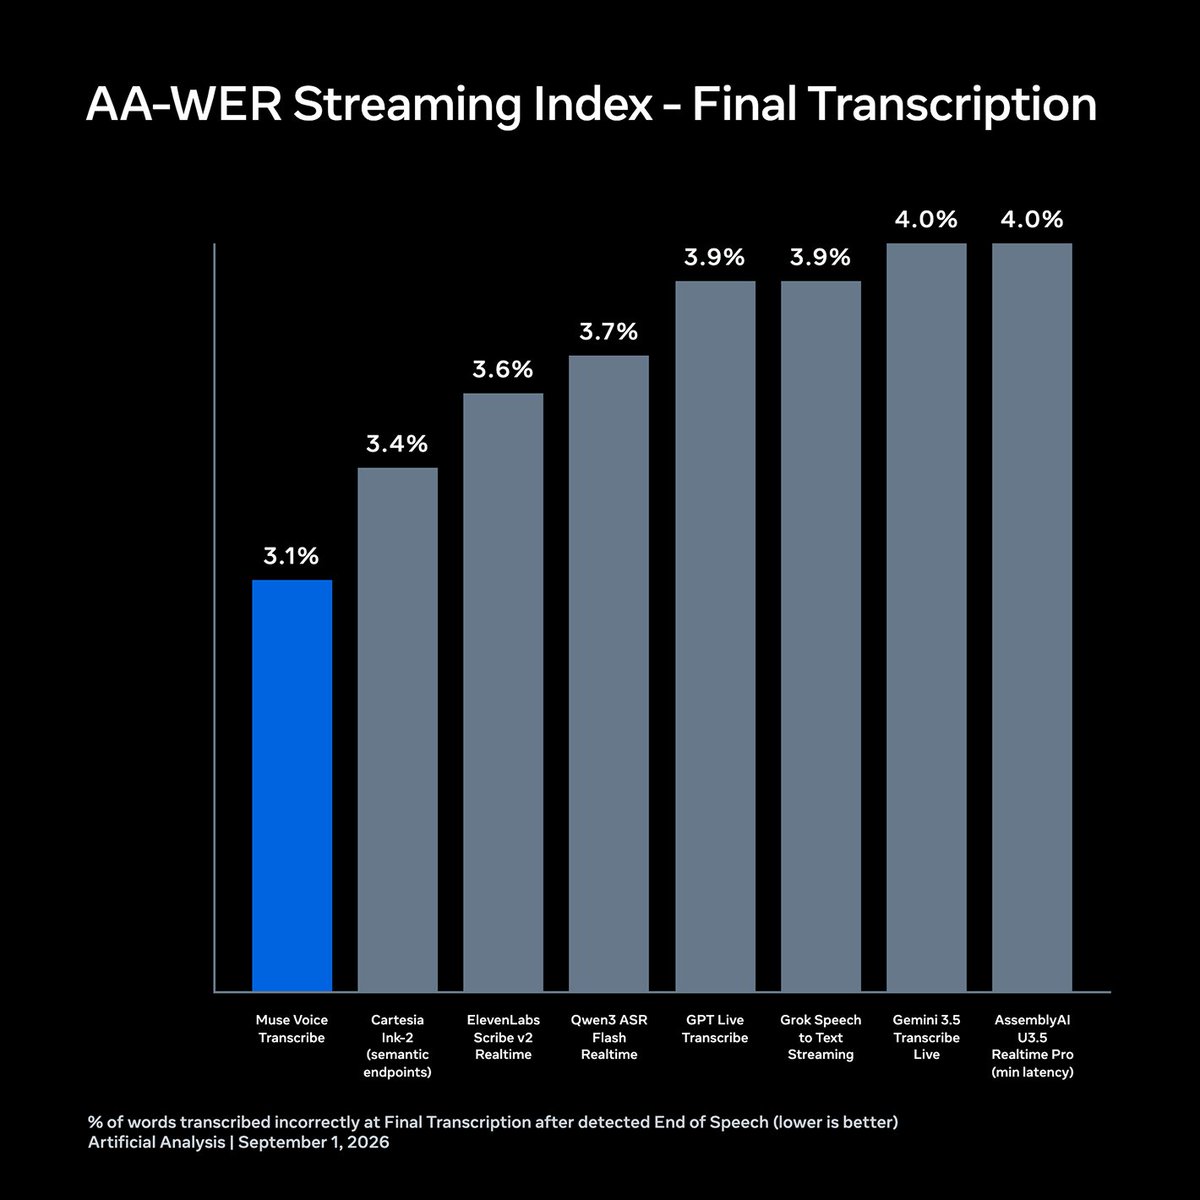
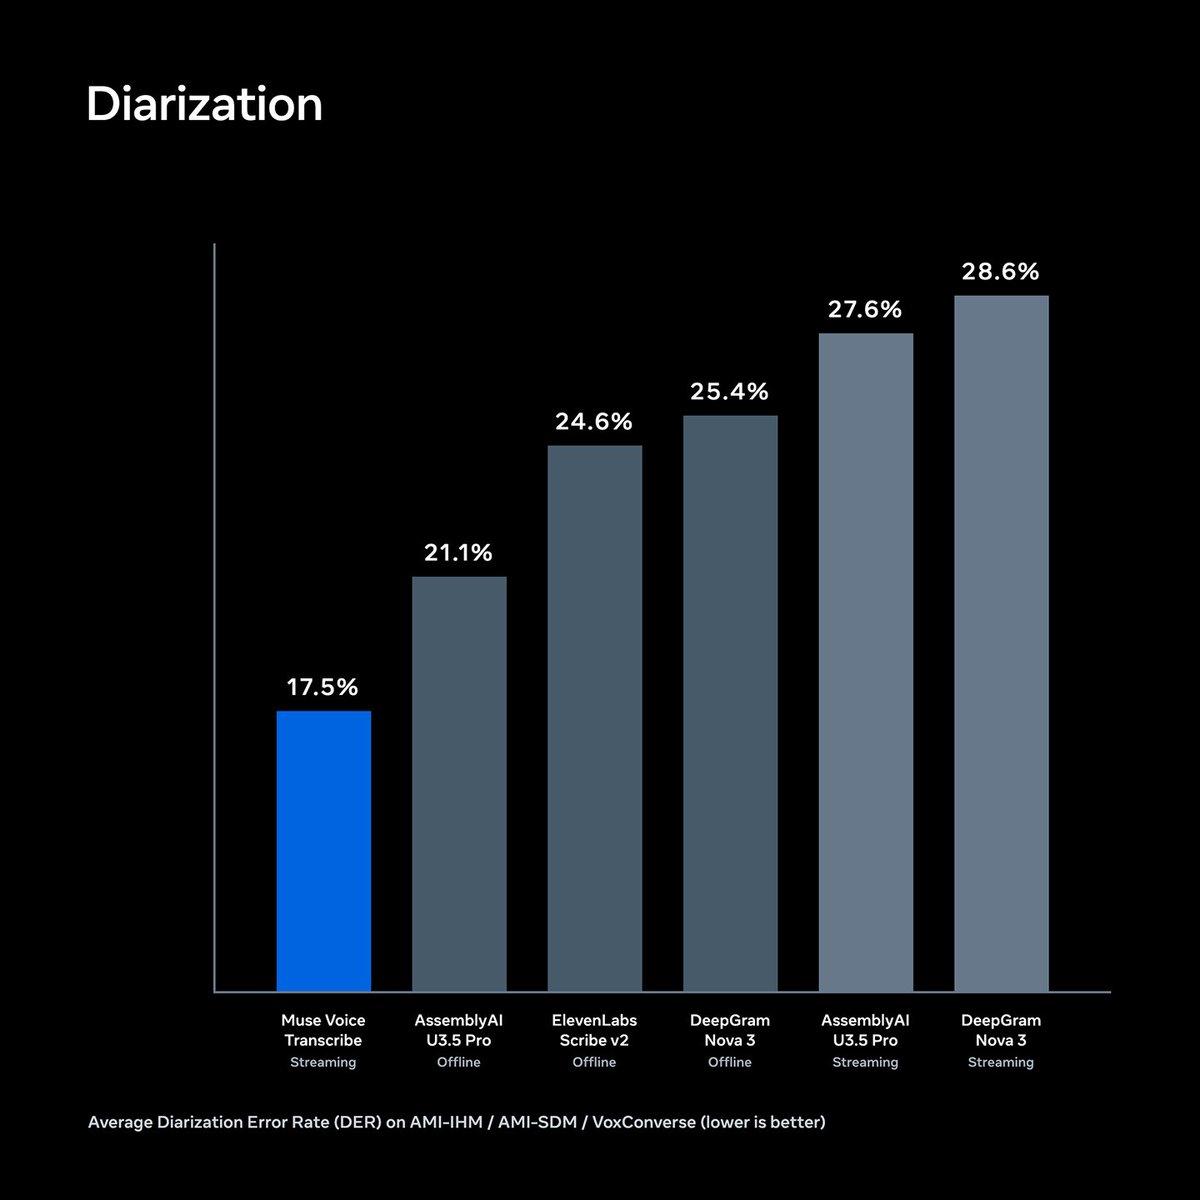
Introducing Muse Voice Transcribe, the first real-time audio perception model from Meta Superintelligence Labs. Muse Voice Transcribe delivers real-time streaming ASR, diarization with 20+ speakers, and endpointing. It’s multilingual with seamless code-switching and improves accuracy with language, keyword, and context biasing. The model ranks first on @ArtificialAnlys streaming speech-to-text and on public diarization benchmarks.
