
Key Info
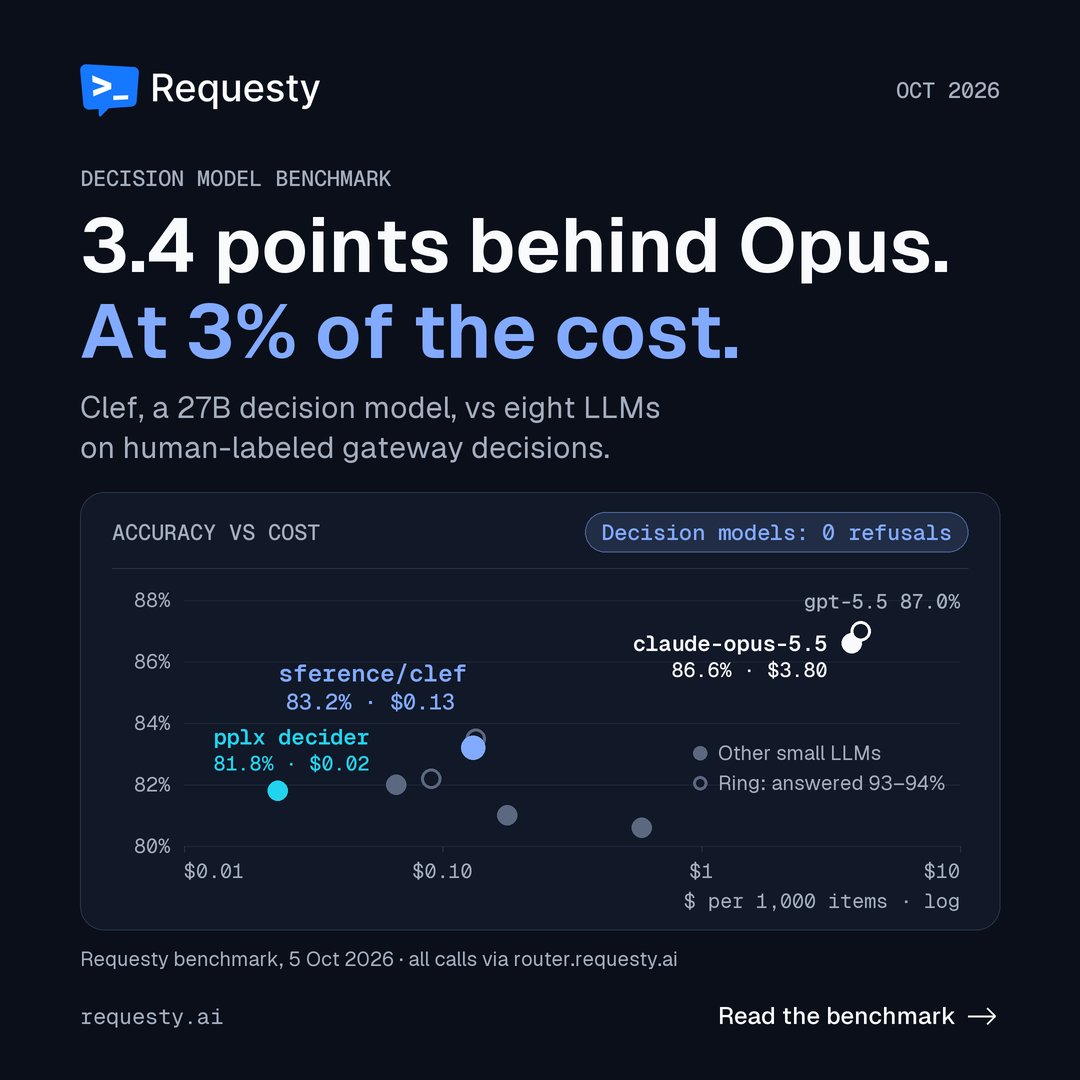
Requesty benchmarked 22,000 decisions across 3 decision models and 8 LLMs on human-labeled gateway tasks, comparing accuracy against cost.
Highlights
- Clef (27B) achieved 83.2% accuracy at $0.13 per 1K items
- Opus 5.5 achieved 86.6% accuracy at $3.80 per 1K items
- Opus 5.5 is ~29x more expensive per 1K items for a ~3.4 point accuracy gain
- Test set covers human-labeled gateway routing decisions