核心信息
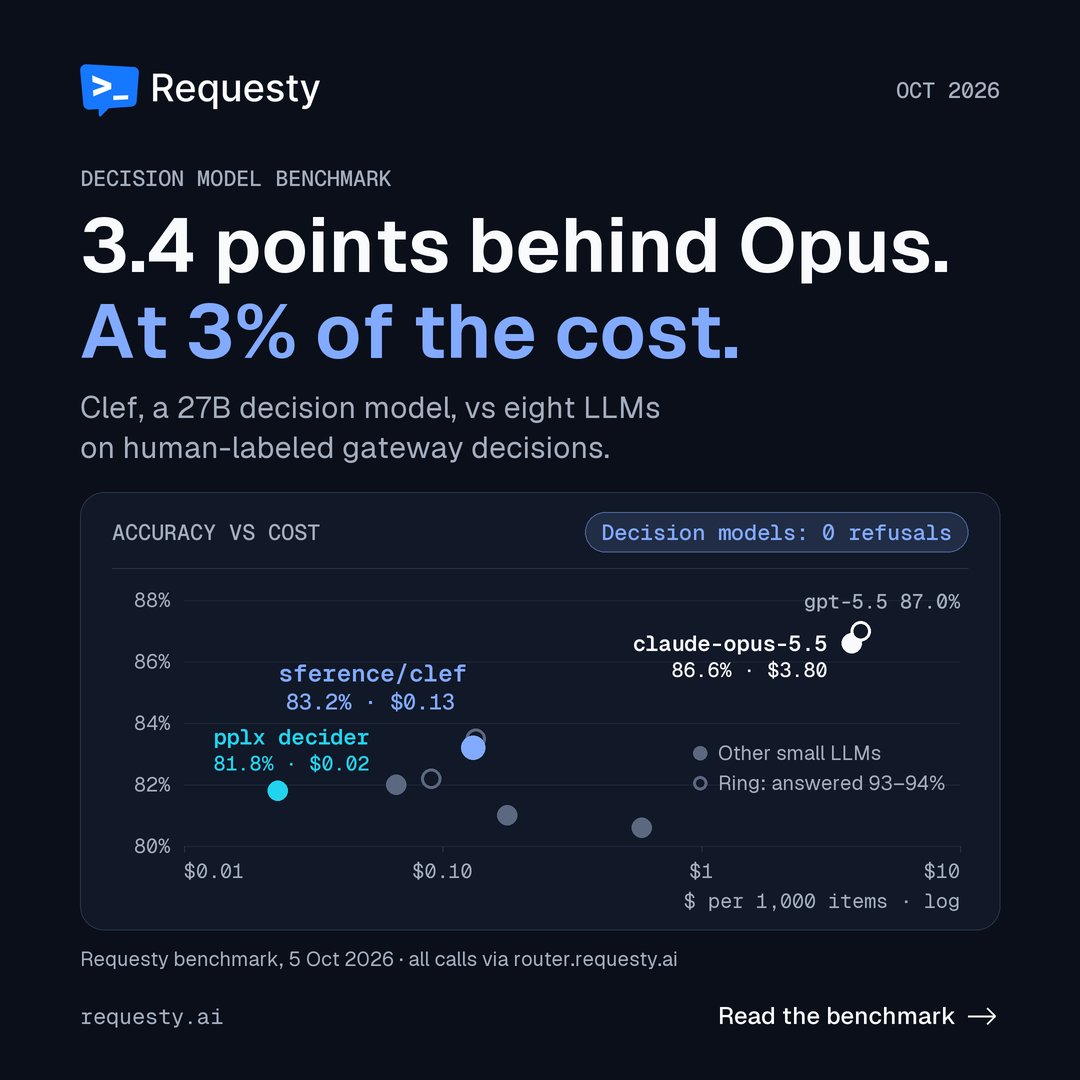
Requesty 在人工标注的网关任务上,对 3 个决策模型和 8 个 LLM 共 22,000 次决策进行了准确率与成本的对比测试。
要点
- Clef (27B) 达到 83.2% 准确率,成本为每千条 0.13 美元
- Opus 5.5 达到 86.6% 准确率,成本为每千条 3.80 美元
- Opus 5.5 每千条成本约为 29 倍,但准确率仅高出约 3.4 个百分点
- 测试集覆盖人工标注的网关路由决策
Requesty 在人工标注的网关任务上,对 3 个决策模型和 8 个 LLM 共 22,000 次决策进行了准确率与成本的对比测试。