
核心信息
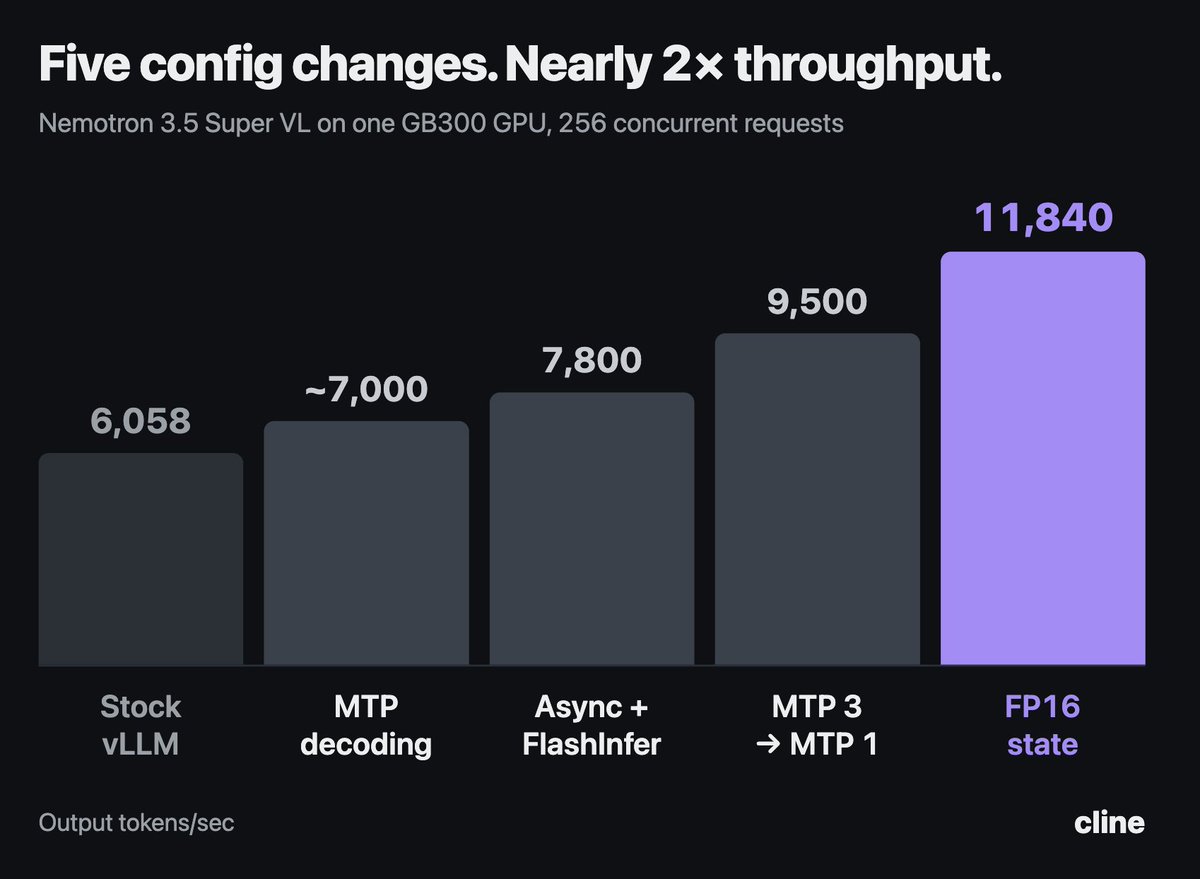
Cline 通过五项 vLLM 配置调整,在单块 GB300 GPU 上将 Nemotron 3.5 Super VL 的推理吞吐量从 6,058 tok/s 提升至 11,840 tok/s,接近翻倍。
要点
- 单块 GB300 GPU 上吞吐量从 6,058 tok/s 提升至 11,840 tok/s。
- 性能提升来自五项 vLLM 配置调整。
- 这些调整让模型可提前预生成 token、避免 GPU 空闲,并以半精度存储模型内存。
- Cline 表示已发布更多关于这些技术以及本地模型与智能体推理未来的细节。