核心信息
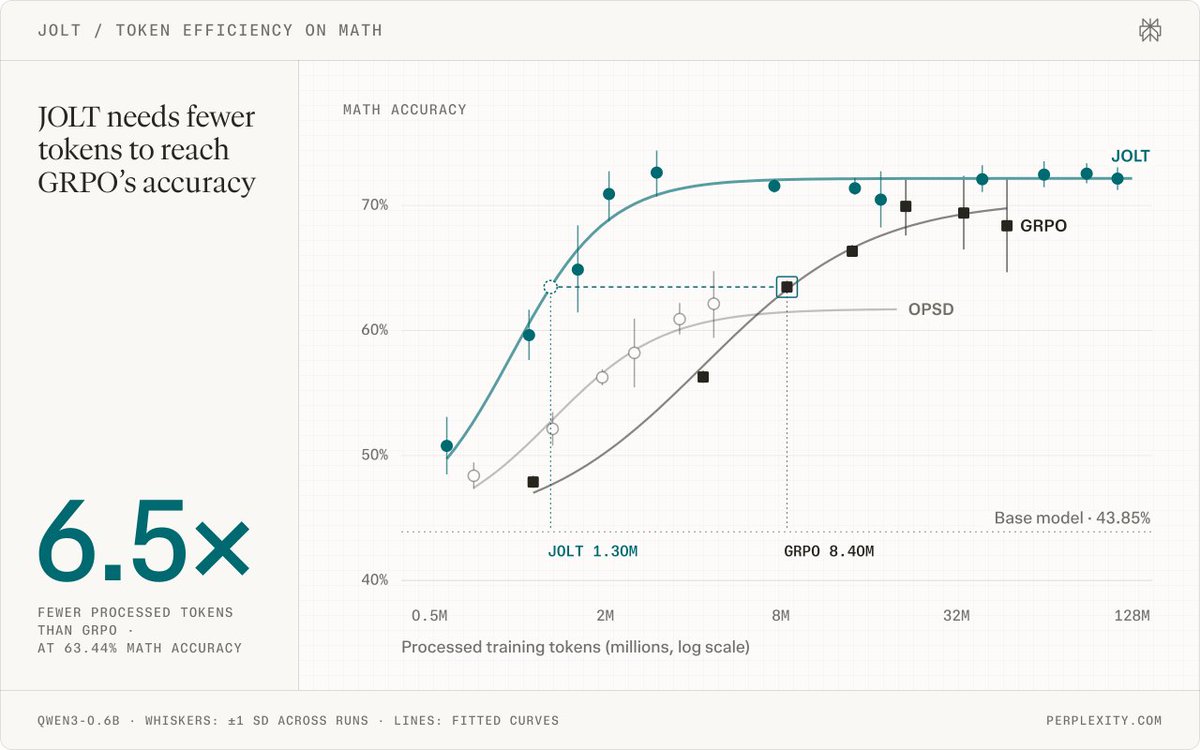
Perplexity 研究人员开发了 JOLT 后训练方法,让同一个模型同时充当教师和学生,并训练教师给出学生真正能用的反馈。在 MATH 上,它以 6.5 倍更少的训练 token 达到了 GRPO 的精度。
要点
- 传统自蒸馏只训练学生,教师可能利用学生无法获得的捷径信息;JOLT 同时用教师自身尝试的结果奖励来训练教师。
- 当教师的预测与学生出现分歧时会施加惩罚,以保证反馈可用。
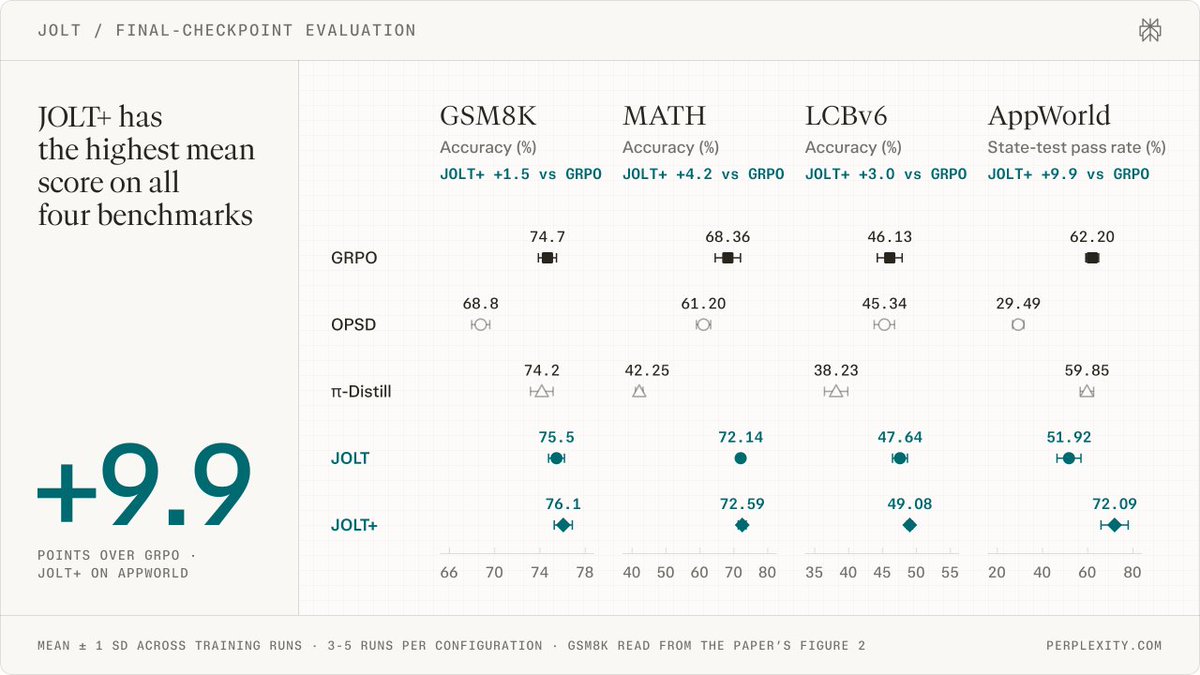
- JOLT+ 在数学、编程、工具使用和终端任务共五项基准上全部超过 GRPO。
- 在 AppWorld 上比 GRPO 高出 9.9 分。