
核心信息
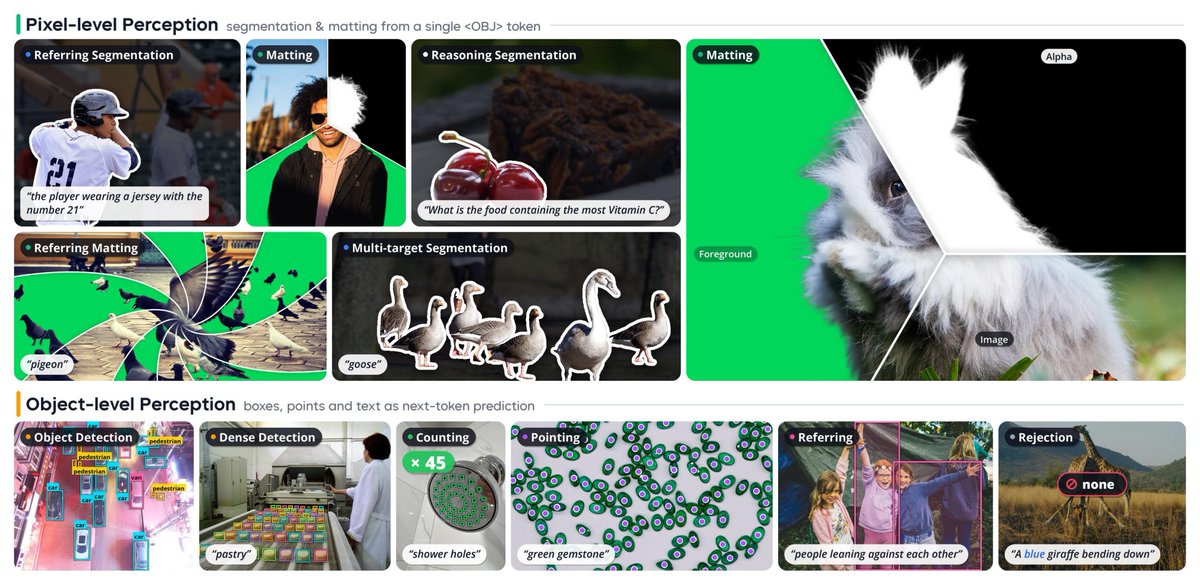
腾讯开源 WeVisOne-VL,这是一个 4B 视觉语言定位模型,当图像中不存在所查询目标时返回 None,而不是强行输出一个框。
要点
- 在团队自建的 WeRef 基准上,对不存在目标的查询拒绝率为 96.4%;在公开基准 Ref-ZOM 上为 86.0%。
- 同一套权重覆盖过去需要多个模型完成的五项任务:检测、计数、OCR、掩码与 alpha matte。
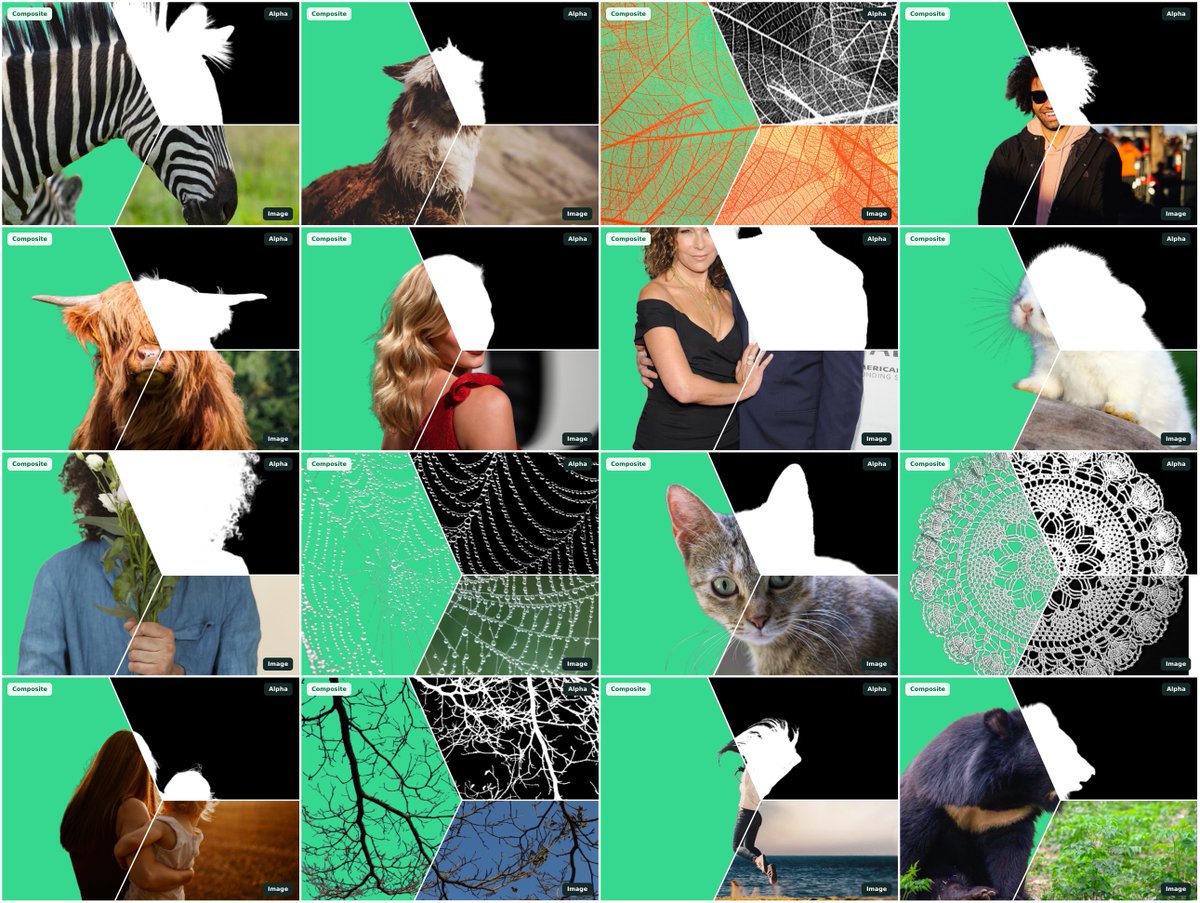
- Alpha matte 由 9.6M 参数解码器生成,提供逐像素的软透明度,比二值掩码更好地保留毛发、绒毛和半透明边缘。
- 流程中不使用 SAM,目前仅支持图像;分数可用仓库中的评测代码复现。